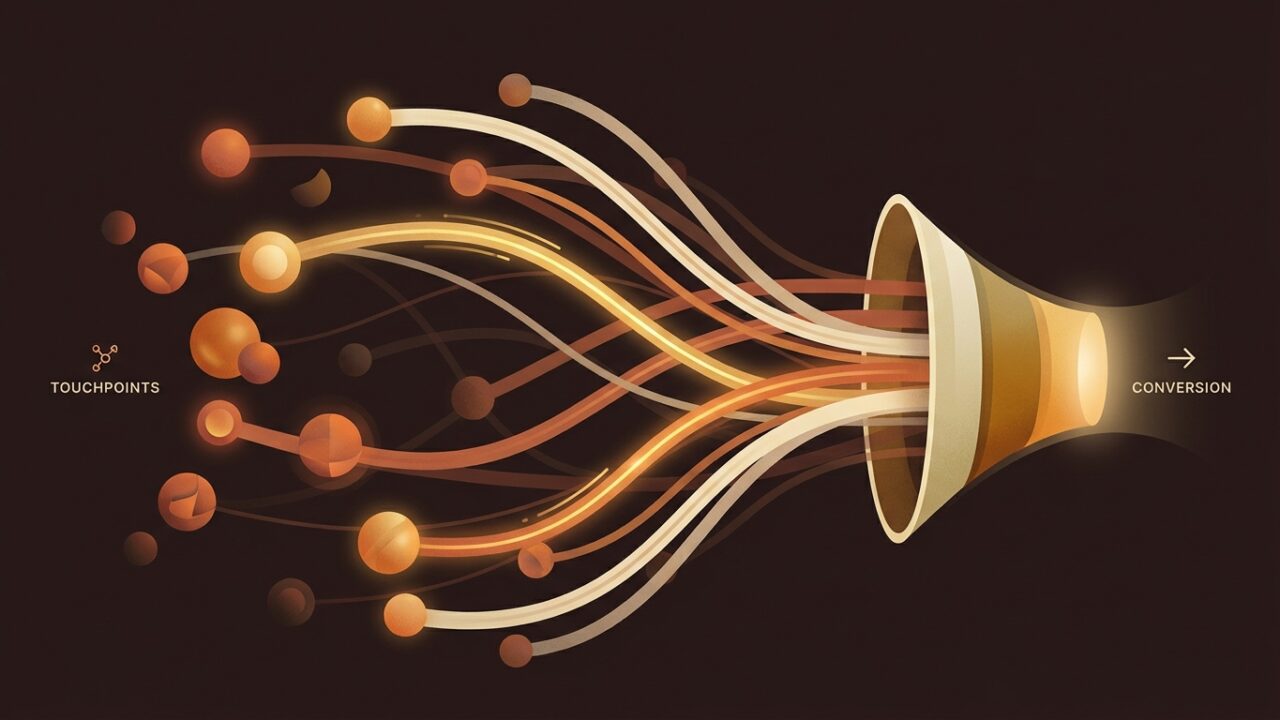
归因要回答一个问题:用户买了东西,这笔功劳算给谁?
渠道多了之后这个问题就绕不过去了——用户先看了小红书的测评,又点了百度竞价,最后在官网下了单。这单该算给谁?
为什么没有标准答案
因为「功劳分配」本质上是个约定问题,不是事实问题。用户自己也不知道是哪条广告打动的。不同的归因模型,本质是给「决策贡献」定不同的先验假设。
这意味着:模型之间没有绝对优劣,只有是否匹配你的业务。
七种常见模型
1. 末次触点(Last Touch)
把功劳给最后一次点击的渠道。
- 优点:简单、绝大多数平台默认、可信度高
- 缺点:严重低估了上游渠道的种草作用
- 适用:直接响应型业务(搜索竞价、电商促销)
2. 首次触点(First Touch)
把功劳给第一次点击的渠道。
- 适用:品牌认知阶段重要的业务(新品教育、长决策周期产品)
- 缺点:高估了曝光型渠道
3. 线性归因(Linear)
各触点平分功劳。
- 优点:无偏、容易沟通
- 缺点:等于放弃了「哪条渠道最关键」的判断
- 适用:需要向非技术方解释时
4. 时间衰减(Time Decay)
越接近转化的触点权重越高,指数递减。
- 适用:短决策周期、需要区分「辅助触点」和「临门一脚」的业务
- 缺点:参数(衰减周期)需要调
5. 位置归因(Position Based / U型)
首次和末次各占 40%,中间平分。
- 适用:需要同时尊重「种草」和「收割」两个阶段
- 评价:折中方案,但本质仍是人为约定
6. 数据驱动归因(Data-Driven)
用机器学习从数据里找各渠道的边际贡献。
- 优点:理论上最接近真实贡献
- 缺点:需要足够大的数据量和转化量才能训练;小样本下会过拟合到无法解释
- 适用:月转化量过千、有专职分析团队的公司
实际怎么用:别只用一个模型
务实的做法是多模型交叉验证:
- 同时跑末次触点和数据驱动,看两者结论差异有多大
- 差异大的渠道,就是你认知最模糊的地方,值得单独做实验
- 用实验结果(真实的增量测试)去校准归因结论
- 你的转化周期多长?超过 30 天的决策链路,末次触点几乎无意义
- 各渠道的流量占比是否悬殊?如果 80% 转化都来自一个渠道,归因模型怎么选都不影响结论
- 是否支持多触点归因?只能做单触点的平台工具在当前基本不够用
- 能否导出触点明细做二次分析?
- 归因不是因果。它描述「用户路径」,不证明「撤掉这个渠道销量会跌」
- 平台数据不可全信。各平台的归因窗口(点击后多久算转化)设置不同,跨平台对比时要统一
- 小流量业务做数据驱动归因基本无效,样本量不够
- iOS 隐私政策后,跨设备归因精度显著下降,任何声称精准的方案都要打折看
- Google Analytics 4 官方归因文档(提供多种归因模型配置)
- Adobe Analytics、Amplitude 的归因模型文档
- 《广告法》与各平台广告数据使用规范中对归因口径的说明
归因模型给出的是假设,增量测试给出的是事实。 两者不可互相替代。
选型要点
适用边界
与相邻概念的区别
| 概念 | 回答的问题 | 区别 |
|—|—|—|
| 归因模型 | 之前的触点该分多少功劳 | 基于历史路径的统计推断 |
| 增量测试(Incrementality) | 撤掉这个渠道销量会怎样 | 用随机实验证明因果 |
| MTA(多触点归因) | 同上,是归因的主流方法 | 是归因的一个类别 |
| MMM(营销组合建模) | 宏观上各渠道贡献多少 | 用统计模型在聚合数据上做,适合大预算品牌 |
| UTM 参数 | 单个渠道的流量来源标记 | 是底层数据采集手段,不是归因方法 |