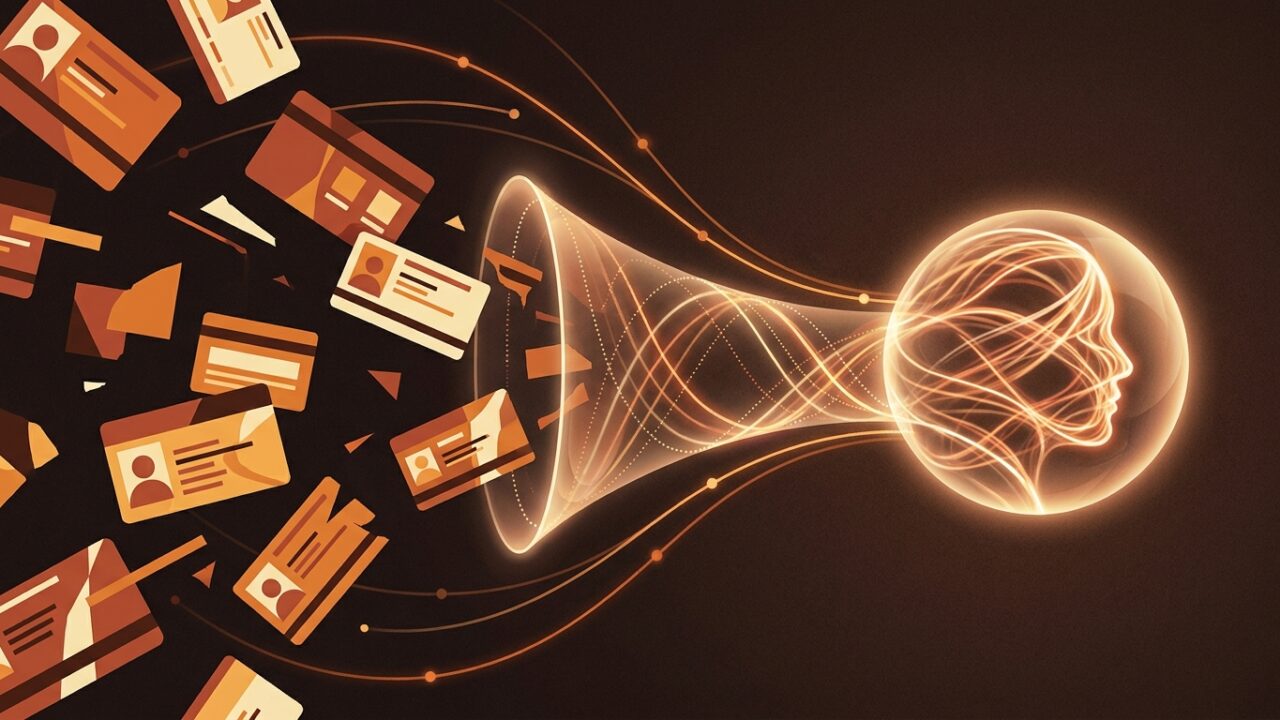
先说结论:CDP 不是「存数据的仓库」,它是一个把分散数据拼成「一个人」的引擎。
它解决什么问题
典型的场景是这样的:同一位客户在你这里有三条记录——
- 电商小程序下过单,绑了这个手机号
- 线下门店办过会员卡,用了另一个手机号
- 客服系统里有个记录,只有姓名和一个座机号
你给这位客户发短信,用哪个手机号?他算老客还是新客?如果他是老客,为什么还在给他发新客优惠券?
CDP 干的就是这件事:建立客户身份解析(Identity Resolution),把散落的记录合并成一个 unified profile。
核心构成
一个典型的 CDP 有这几层:
1. 采集层(Ingestion)
对接各种数据源:电商系统、CRM、客服工单、线下 POS、第三方数据。关键是支持实时流式接入,不只是定时批量拉取。
2. 身份解析层(Identity Graph)
CDP 的技术核心。判断「这两条记录是不是同一个人」。常用信号:手机号、邮箱、身份证、设备 ID、收货地址、行为序列。
难点在于误合并和漏合并:
- 误合并(把两个真人合成一个)→ 会把 A 的行为推给 B,推荐全错
- 漏合并(同一个真人拆成两个)→ 触达被重复打扰,客户体验崩
一个成熟的 CDP 应该能让你查看和手工修正合并结果,这一点常被忽略,却比算法精度更影响实际效果。
3. 数据治理层(Data Governance)
字段标准化、去重、时间线合并(同一客户在不同时间的行为要串成时间序列,而不是互相覆盖)。
4. 标签与人群层(Segmentation)
打标签(会员等级、生命周期阶段、品类偏好)、圈人群、对外同步到投放平台。
5. 激活层(Activation)
把人群同步到 MA、SCRM、广告平台去执行。CDP 的价值不在存储,在于能激活。 一个不能对接执行渠道的 CDP 只是个更贵的仓库。
实际怎么用:五步落地
- 先做数据源盘点——列出你能拿到哪些数据、字段是什么、更新频率多快
- 选一个明确场景——比如「找出 90 天未复购的高价值客户」。没有场景的 CDP 项目一定失败
- 最小化起建——先接 2-3 个数据源跑通链路,别一上来全接
- 人工校验准确率——抽 100 个客户,比对 CDP 合并结果和实际认知的偏差
- 闭环到执行——人群必须能推到 MA 或广告平台,否则数据会烂尾
- 身份解析准确率是多少?能不能看到具体的合并逻辑?
- 支持实时流式接入吗,还是只有定时批量?
- 能不能对接我们现有的 MA 和广告平台?
- 数据合规怎么处理的?数据存哪、能不能按字段删除?
- 标签体系是内置的还是需要我们从零建?
- CDP 解决的是「识人」,不解决「触达」。它不能替代 MA
- 如果你的业务根本不需要跨渠道识别同一个人(比如纯站内电商),CDP 可能是过度设计
- 身份解析永远做不到 100% 准确。把 CDP 当成「大幅减少误差」而不是「彻底解决」,心理预期要对
- 数据合规是硬约束,国内涉及个人信息保护要求,跨境场景还要考虑数据出境政策
- 主流 CDP 厂商(Adobe Real-Time CDP、Salesforce Data Cloud、Twilio Segment、神策)的公开产品文档
- 国内《个人信息保护法》对数据最小必要原则的要求
选型要点
看 CDP 别只看功能列表,问这五个问题:
适用边界
与相邻概念的区别
| 概念 | 核心问题 | 区别 |
|—|—|—|
| CDP | 把记录拼成「一个人」 | 以客户为中心 |
| DMP | 圈选人群包做投放 | 以受众为中心,不解决单体识别 |
| 数据仓库 | 存和算 | 存原始数据,不做身份解析 |
| MDM | 管主数据(产品、供应商) | 管的是「物」不是「人」 |
| CRM | 记录销售互动 | 偏流程管理,CDP 偏数据整合 |